AI 开发者,应该有自己的 AI 网关
Codex、Claude Code、Pi、OpenCode 轮着用,模型散在四五家服务商。把调用入口收敛成一层之后,换模型、管 Key、处理限流都省事了。Magpie 现在既能装在电脑上,也能 Docker 部署到服务器当公网网关。附几款网关的选型对照和我的实际配法。
以前写代码,配置一个 API Key 就够了。
现在手里往往不止一套工具:Codex、Claude Code、Pi、OpenCode 轮着用,模型也分散在 OpenAI、Anthropic、DeepSeek、GLM、Kimi 这些不同的地方。
工具多是好事,管理起来却越来越麻烦。
有时只是想换个模型,就得翻配置文件、改 Base URL;有时某个渠道临时限流,正在跑的任务就停在那儿;几个 Agent 同时干活,月底看账单,甚至说不清哪一项任务花了多少 Token。
我的判断很简单:只要开始长期用多个 Agent 干活,就值得给自己搭一个 AI 网关。
网关到底解决什么问题
它站在开发工具和模型服务之间。Codex、Pi、Claude Code 向网关发请求,网关按配置决定这次调用落到哪一家。
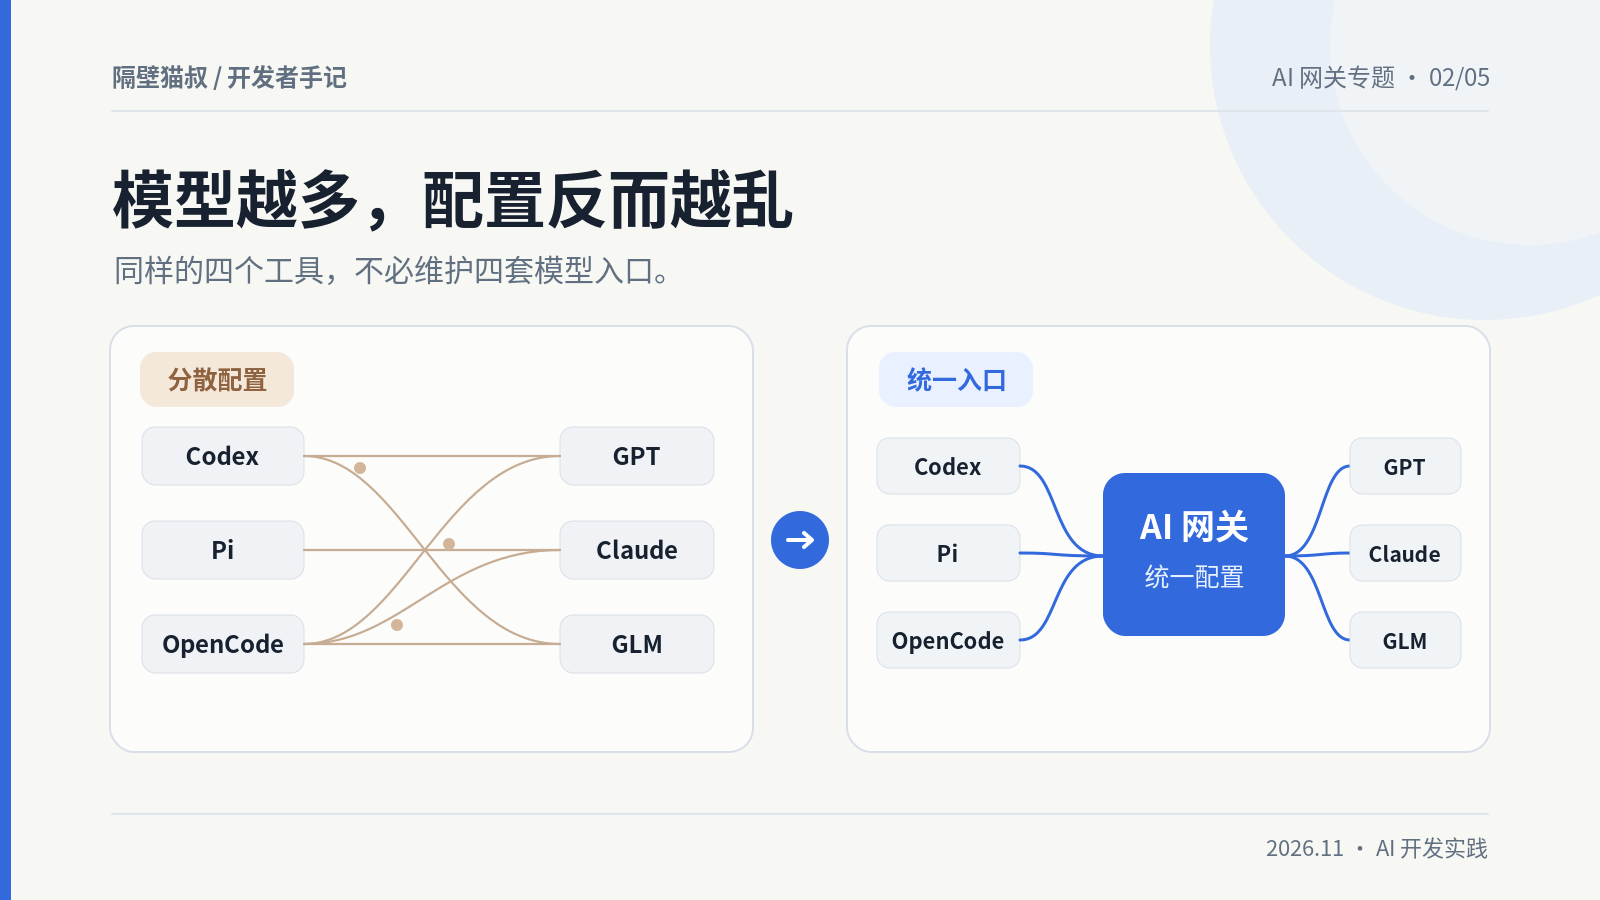
听起来不复杂,但日常那几个麻烦刚好都能一起消掉:
- 换模型。 工具只认网关地址,模型和渠道在网关里切,不用挨个改配置。
- 管 Key。 哪个项目、哪个 Agent 走哪家上游,能分得清。
- 兜失败。 上游不可用时按预设规则切到备用渠道,长任务不至于中断。
- 看用量。 请求数、Token、费用可以按渠道或项目统计。
有一点要说清楚:网关负责调度,不会让额度变多。它省下的是每天来回折腾配置的时间。
Magpie:我自己在用的那个
项目地址:yetone/magpie
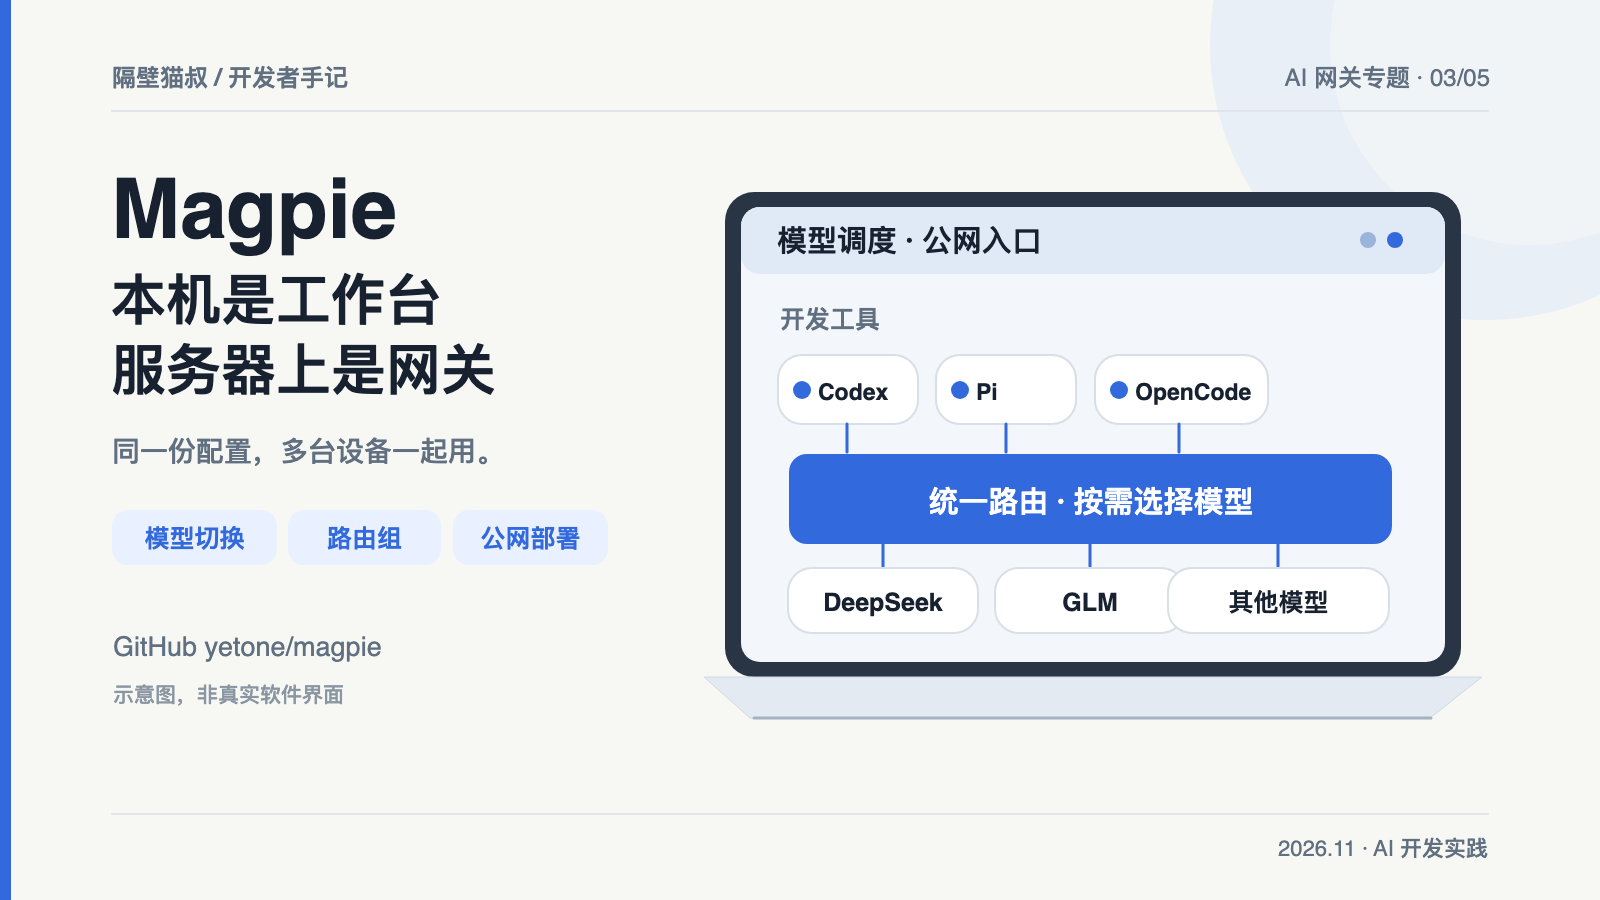
Magpie 不是把几个 API 地址堆在一个页面上,而是直接面向 Codex、Claude Code、Pi、OpenCode 这类 Agent 工具做统一管理。装好之后本机就多了一个网关入口,工具连上去,背后的模型和渠道在 Magpie 里调整。
我比较看重四件事。
统一管理 Agent。 以前每个工具有一套配置,今天给 Codex 换模型,明天给 Pi 加渠道,时间全花在重复操作上。常用的几个工具集中到一处,切换成本才降下来。
路由组。 多个渠道放在同一个组里,设优先级、轮询或故障切换。平时走常用模型,上游抖了按规则转到备用,对长时间跑的 Agent 任务比手动改 Key 实用得多。
用量和额度。 多个服务商分别登录查用量,很容易漏。Magpie 能集中展示经过网关的调用,部分来源还能看到剩余额度,至少知道哪个 Agent 最费 Token。
能部署到服务器当公网网关。 这点很多人还没注意到:Magpie 除了本机安装,也支持 Docker 部署到一台服务器上,直接充当公网网关。家里和公司两台电脑、远程开发机、手机端的 Agent,全部连同一个地址,配置只维护一份。原来的做法是每台机器各装一套、各改一遍 Key,现在一个入口就够。
Magpie 支持 macOS、Windows、Linux,也有 Docker、Termux 的部署方式。放在本机它就是顺手的工作台,放在服务器上它就是一对多的公网入口,两种用法可以只选一种,也可以都留着。
这也是我觉得它现在比「个人工作台」这个定位更进一步的地方。要让不同设备、不同工具共用一套模型入口,它自己就能干,CPA 则是另一条思路。
CPA:把多个账号接成一个统一接口
项目地址:router-for-me/CLIProxyAPI
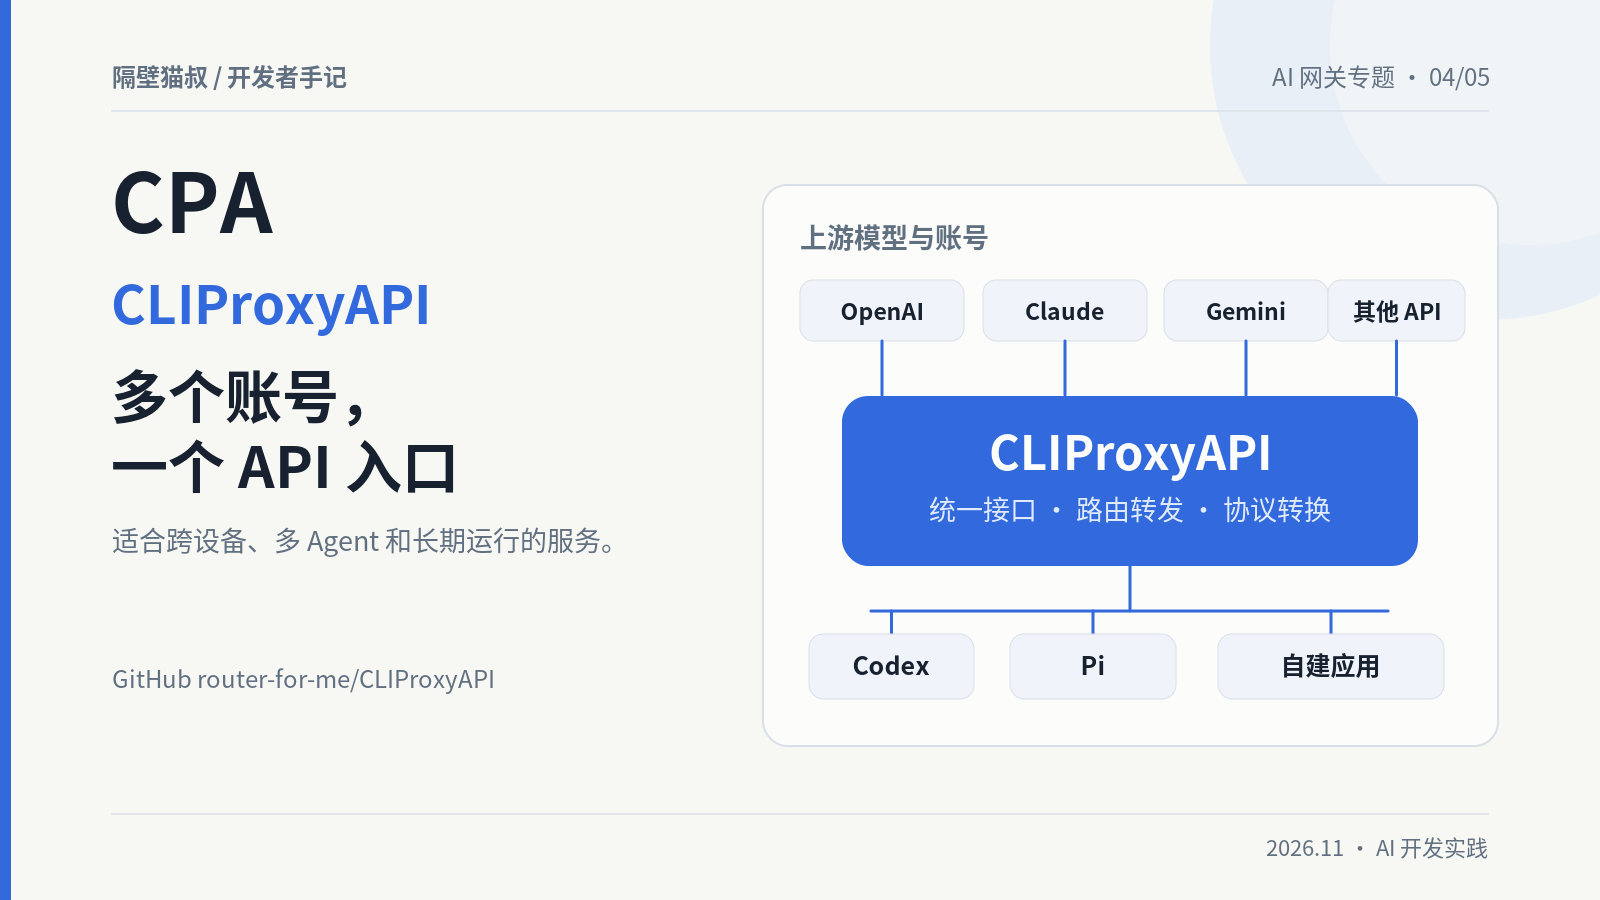
CPA 全名 CLIProxyAPI。它和 Magpie 有不少功能重合,但出发点不一样:Magpie 重视本地 Agent 的使用体验,CPA 先把各种模型来源接成一个 API 服务,再交给任何兼容的客户端调用。
它可以接入 OpenAI Codex、Claude Code、Gemini 这类账号的 OAuth 登录,也支持常见 API Key 和 OpenAI 兼容的上游。对外提供 OpenAI、Claude、Gemini 兼容接口,Codex、Pi、OpenCode 或者自己写的程序都能按对应协议连。
我觉得它最有价值的两点:
一是多账号调度。 同一个来源挂多个账号,CPA 可以轮询分配请求;配合不同渠道配置,原本分散的模型资源能汇总到一个入口。长期并行跑 Agent 的人,比只用一个模型的人更容易体会到差别。
二是把网关做成独立服务。 CPA 可以常驻一台 Linux 服务器,对外只暴露一个 API 地址。电脑、远程开发环境、自建 Bot 用同一个入口,不必每台机器都配一遍上游。Magpie 现在也能这么部署,但 CPA 在这条路上走得更早,配套也更偏服务端。
配套工具也已经成了小生态。想要更完整的调用记录、Token 和成本估算、账号状态,可以加 seakee/CPA-Manager-Plus。
这里有个版本细节要留意:CPA 核心项目从 v6.10.0 起不再内置原来的用量统计,完整的历史记录和可视化统计要靠 CPA-Manager-Plus 这类配套项目补上。
如果你的重点是多账号、多 Agent、统一 API 入口,CPA 应该和 Magpie 一起放在首选名单里。一个偏使用体验和界面,一个偏服务端调度,两者都能上服务器,没必要硬分高下。
另外三个,按场景认领
剩下几个不必都装,先看清自己是哪种情况。
| 项目 | 定位 | 什么时候适合 |
|---|---|---|
| CC Switch | AI Coding 配置控制台 | 主要烦的是 Claude Code、Codex、Pi 之间来回改配置 |
| New API | 服务器上的模型管理后台 | 有 VPS、有网站或 Bot,需要发独立 Key、按项目限额 |
| LiteLLM / Bifrost | 应用后端网关 | 已经有稳定调用量,要做预算控制、负载均衡和性能优化 |
CC Switch 偏向工具配置管理:切 Provider,管 MCP、Skills、Prompts 和各 CLI 的配置,也带一点本地代理和路由能力。如果你最烦的是几个工具之间搬配置,它很对味;要是更看重统一模型入口和多渠道调度,我会先去研究 Magpie。
New API 适合有自己网站和 Bot 的人。把各家 API 接进去,给每个项目发独立的调用 Key,哪个站用了多少 Token、哪个 Bot 能调什么模型、一个项目给多少额度,都在后台处理。渠道权重、故障重试、用量统计也都有。
LiteLLM 更偏应用后端:统一调用方式之外,还能管虚拟 Key、预算、频率、负载均衡和故障回退。
Bifrost 重点是高性能代理、并发、缓存、负载均衡和监控,更偏向高并发 API 服务。产品开始有稳定流量、对延迟和吞吐敏感了,再把它列入备选。
还有一个不用自己维护的选项:Cloudflare AI Gateway。托管服务,已经在 Cloudflare 上跑应用的话,顺手就能加上请求分析和限流管理。
一个人写代码和一个团队运营 AI 服务,需要的网关根本不是同一个量级。
我现在的配法
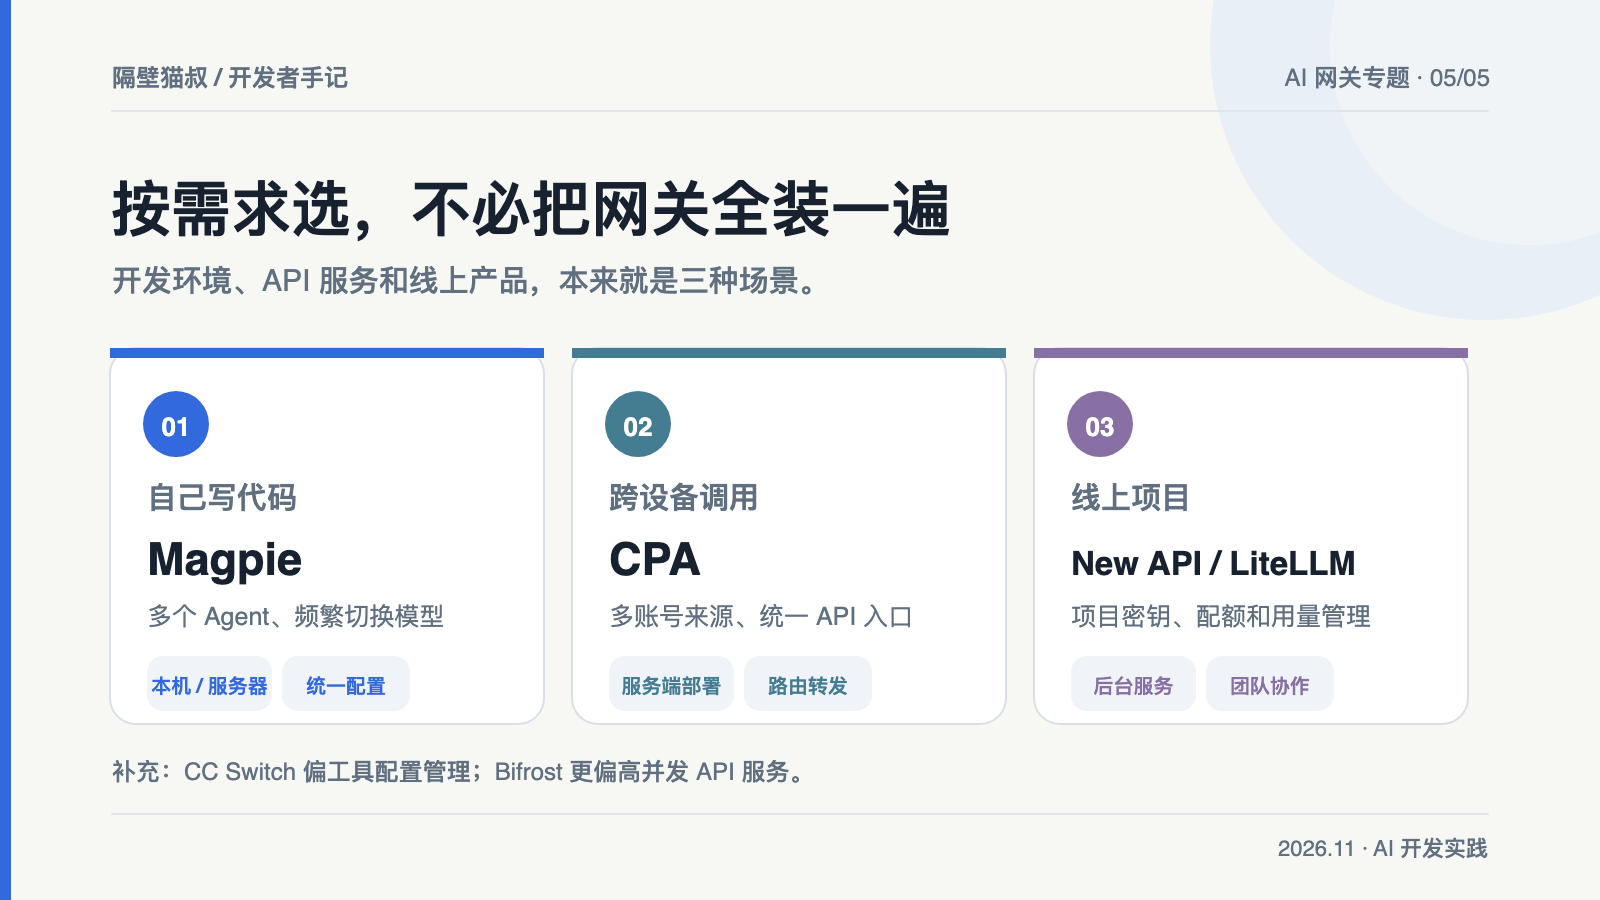
如果从头搭一套,我会这么配:
- 主力用 Magpie:本机装一份当工作台管 Codex、Claude Code、Pi;想让多台设备共用一个入口,就 Docker 部署到服务器上当公网网关。主要只是切配置,看 CC Switch。
- 有多个账号、希望网关作为独立服务长期常驻,用 CPA,要统计监控再加 CPA-Manager-Plus。
- 自己的网站、Bot、自动化任务主要靠各家 API Key 接入,就在 VPS 上部署 New API。
- 等调用量稳定了,对预算、负载、性能有更细的要求,再研究 LiteLLM 或 Bifrost。
一开始别把架构搭复杂。先把最烦人的模型切换和 Key 管理解决掉,收益就已经很明显。
模型可以经常换,自己的调用入口最好固定下来。
目前我是用 Magpie 部署在美国服务器上充当 AI 网关。国内服务商里反代好用的是 WorkBuddy、华为云码道、讯飞 Loomy 等,限速比较少。DeepSeek V4.1 Flash 目前已经 Token 自由了。