我把几十台服务器的运维做成了一个工程项目:带 AI 当搭档的半年手记
从手把手带 AI 维护一两台节点开始,到一百多篇运维日志沉淀成它的“外挂记忆”,再到它能照着我的习惯接管新机器、新业务。中间穿插一个“不肯更新”的 426,和一台在 OOM 里打转的小机器。文末附直接可用的 AGENTS.md 规范模板。
机器一多,运维就慢慢从乐趣变成了家务。
我手里有美西、亚太、欧洲的十几台 VPS,家里还有几块开发板和一台小服务器,加起来几十个节点。上面跑着静态站、反代、模型网关、一堆容器和定时任务。
家务大概是这些:上游发了新版,一台台上去下载、校验、替换、重启;某个运行时爆了漏洞,挨个确认版本、打补丁、测连通。还有那种熟悉的时刻:开着五个终端,突然不太确定自己现在在哪台机器上。
今年 3 月,我开始让终端里的 AI Agent 帮忙。
顺便提一句工具底座:我目前日常运维的主力模型是 Gemini 3.8 Flash。很多人好奇为什么不用更大、更贵的模型,原因其实特别实在——它又快,又够用。日常运维的大部分活是查状态、翻日志、比对版本和执行确认过的短命令,最重要的是响应低延迟、不打断思路。在规矩立好的框架里,Flash 几秒钟就能吐出排查结果,执行力完全在线。
半年过去,回头看,最有意思的不是它替我干了多少活,而是它怎么一点点学会了“按我的方式”干活。
这个过程大概分四步。
一、先带徒弟
一开始我没打算把钥匙交出去。我只挑了一两个节点,坐在旁边,跟它结对操作,有点像 Pair Programming,只不过对象是服务器。
我有几条用了很多年的运维洁癖,那段时间就一条条地“传”给它:
只认 SSH 别名。 所有连接信息放在本地 ~/.ssh/config,起好别名,比如 us-proxy-01、kr-gateway。对话里从不出现 IP 和密码。只跑一次性命令,ssh kr-gateway 'uptime' 这种,不开交互会话,每一步都留在记录里。
先看后动。 排查问题时先摸清现状,再谈改什么。
改之前先留一份。 动任何配置或程序之前,把原文件复制到 /root/backup/<服务>/<日期>-before-<版本>/。碰到 SQLite,先停服务再备份。换程序用“写临时文件再 mv”的方式,换完顺手留一行能直接粘贴的回滚命令。
退出码 0 不算数。 systemctl restart 返回 0,只说明它听到了,不说明它做到了。每次变更后看三样:服务确实在跑;不带 Key 的请求确实被挡在外面;带 Key 的真实调用确实返回了正常结果。有一项不对,就退回去。
这些规矩没有一次性写成文档。是它做错一步,我纠正一句;它做对了,我说“对,就这样”。很像带徒弟,靠的是一遍遍做给它看。
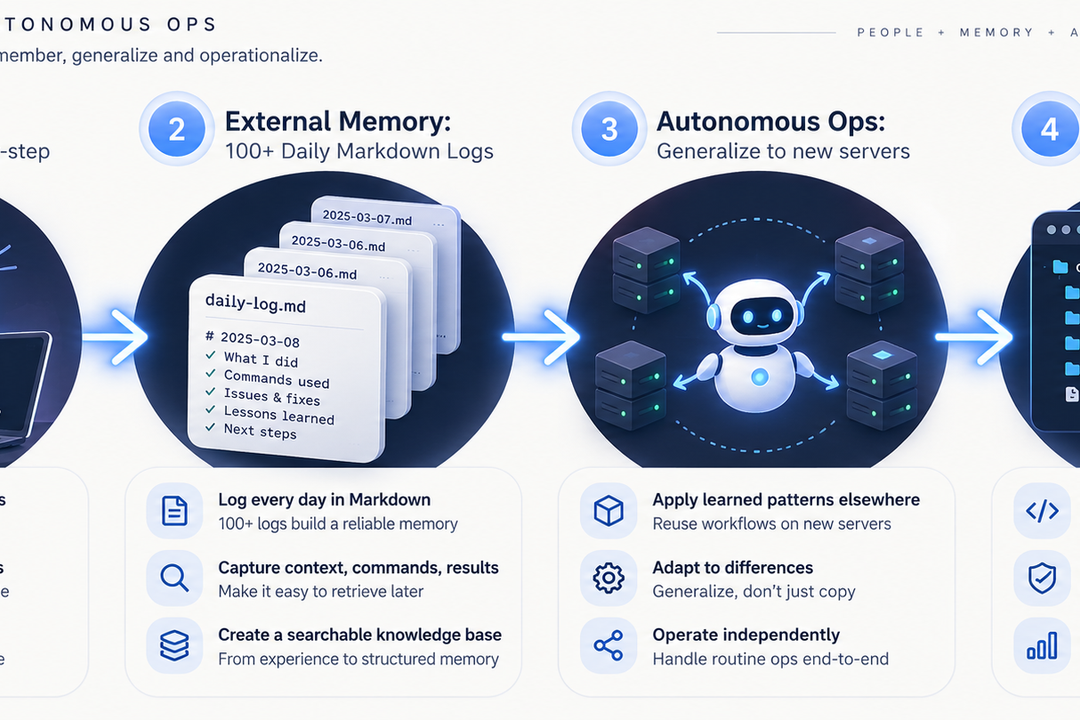
二、让它写日志,当作外挂记忆
带徒弟有个麻烦:AI 每次新开会话都会忘。昨天教会的,今天又得从头来。
所以我加了一条要求:每次干完活,写一篇本地运维日志,放在 logs/ops/YYYY-MM-DD.md。为什么改、改了哪几台、前后版本、备份放在哪、怎么回滚,一样不落。
下次开工,我只要说一句“先读一下最近的运维日志”,它就接上了。
起初只是为了解决失忆。不知不觉,从 3 月到现在,攒下了一百多篇。这些日志成了它的记忆,也成了我的。很多我自己早忘了的决定,比如某台机器为什么没装 Swap、某个服务为什么锁在旧版本,都能在里面翻到原因。
更要紧的是,日志里记的不只是“做了什么”,还有“怎么做”。我的那些习惯,就这样被写进了文字,留了下来。
三、熟悉了风格,它开始自己接活
日志攒到一定数量后,变化悄悄发生了。
后来我加了新 VPS,新上了反代、模型网关、sing-box 节点,都没再手把手带。一句话交代下去,它会先读历史日志,然后照着熟悉的路子来:用别名连接,先看现状,列计划,备份,变更,三项验证,写日志,附回滚。交付出来的东西,和我自己干的几乎看不出区别。
真正让我意识到“它懂我了”的,是两次排障。
一个“不肯更新”的 426
某天,一台网关上的模型服务开始报错:
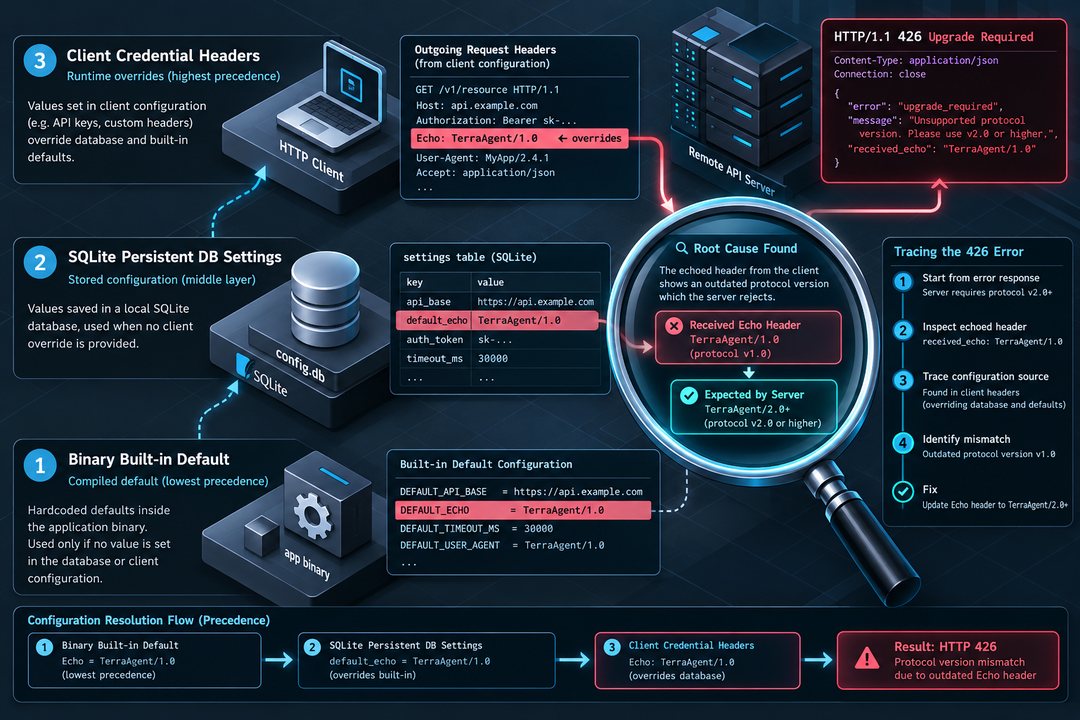
426 Your Grok CLI version (0.2.93) is outdated. Please update to version 1.0.13 or later...意思很清楚:客户端太旧了,升级吧。
于是升级。它把网关换到最新版,还翻了源码确认:程序会自动获取最新版本号,当时已经是 1.0.70,远高于门槛。
再试,还是 0.2.93。
更怪的是,换到另一台机器上测,报错里的版本号变成了 0.2.99。两台机器跑着同一个最新版程序,各自坚称自己是一个不同的旧版本。
它没有在服务器上继续打转,而是去翻上游仓库的 Issue 和 PR,找到了关键的一句:报错里的版本号,是服务端把客户端请求头里的版本原样念回来的。
也就是说,不是上游错了,是我们自己一直在报 0.2.93。问题不在“程序是不是新的”,而在“是谁替程序说了话”。
顺着这条线就好找了。网关里存着一百多份账号凭据,大部分里面都存着一段早年的自定义请求头:"x-grok-client-version": "0.2.93"。凭据里的 header 优先级高于程序默认值,轮询抽到这些账号,就替程序报出了旧号码。
那 0.2.99 呢?另一台是容器部署。它进到数据卷里的 SQLite,在 runtime_settings 表里找到了答案:三个月前初次配置时,有人(大概率是我)把 "ClientVersion":"0.2.99" 存进了数据库。容器每次启动都读这份设置,把默认值又盖了一遍。
收尾很简单:清掉凭据里的旧 header;先备份数据库,再改设置,重启容器,回归测试通过。
前后十来分钟。换成我自己,大概会在“上游是不是有 bug”这一步卡上一个下午。
这件事教会我的是:一个值,可能在好几个地方被写过。 程序默认值、凭据、数据库,越往后越容易被忘。
而让我会心一笑的是它的路数:先确认现状,再查证据,动数据库前先备份。全是我当初带它时反复唠叨的那几步。
一台在 OOM 里转圈的小机器
一台 1GB 内存的小实例开始丢包,SSH 时断时续,服务频繁 502。
看着像网络问题。它没急着改东西,先从别的节点做链路探测,排除了网络,再去翻内核日志,看到了真相:网关进程在内存泄漏,机器没有 Swap,短时间内被 OOM 杀了四次。每次被杀,systemd 马上把它拉起来,然后再涨、再被杀。整台机器就卡在这个循环里,连 SSH 都挤不进去。
处理分两步,先让机器活着:
- 补 1GB Swap,给内存吃紧时留个缓冲;
- 不动原来的 unit 文件,加一个 drop-in,把这个服务的内存上限设在 500M。以后再泄漏,也只是它自己重启,不会拖着整台机器陪葬。
排查配置时,它注意到这个服务本来就会定时把数据同步到对象存储,于是建议在一台闲着的节点上拉一个同样的实例,加上 DNS 轮询。成本几乎为零,单点就这样变成了两台。
泄漏本身还得等上游修。但止血和治病是两件事,先把前者做了,后者就不急。
四、把运维做成一个项目
回头看,这半年真正改变的,是运维这件事的形态。
以前运维活在黑窗口里,活在我的记忆里。哪台机器装了什么、为什么这么配,全靠脑子记,记不住就重新摸一遍。
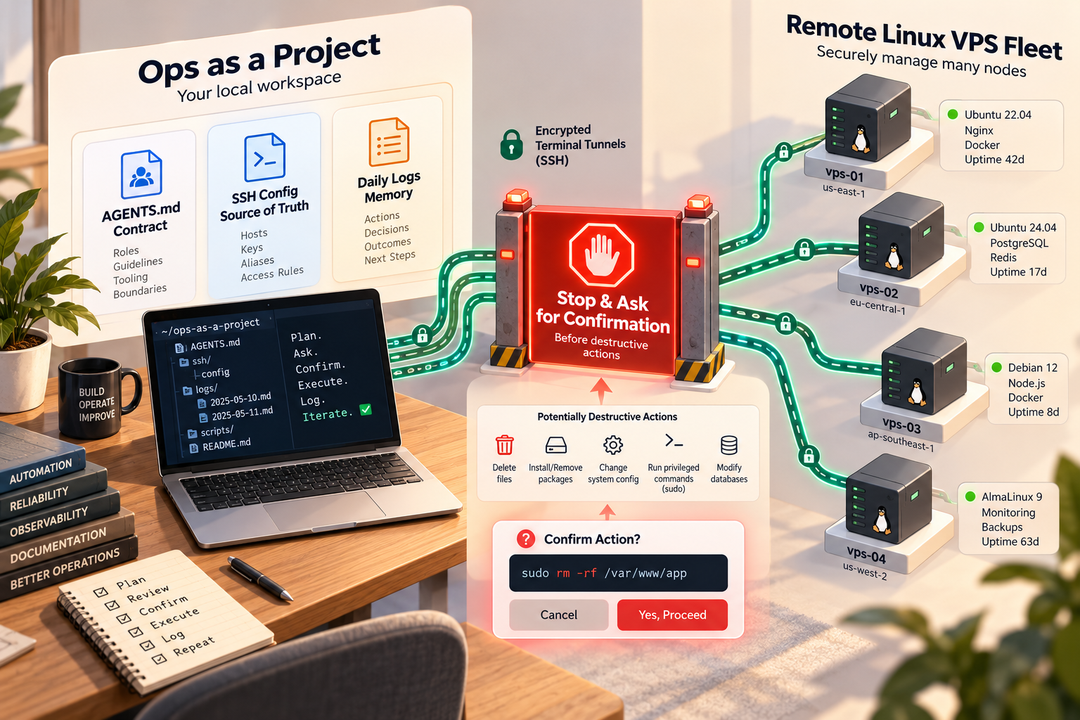
现在它变成了本地的一个工程项目:
Codex/
├── ops/                  # 运维工程目录
│   ├── AGENTS.md         # 协作契约:规矩、边界、什么时候必须停下来问我
│   ├── kr1-proxy/        # 各节点的配置模块、service 单元与自说明 README
│   ├── hk-gateway/
│   └── ...
└── logs/ops/             # 版本化的运维日志库(沉淀半年的外挂记忆)
    ├── 2026-03-19.md
    ├── ...
    └── 2026-10-27.md
AGENTS.md 是当初那些口头唠叨的定稿;~/.ssh/config 是“我在哪台机器上”的唯一答案;节点目录记着每台机器的来龙去脉;日志库则是这半年所有决定的出处。
有了这些,日常就变成了这样:
我:社区说 PHP 出了个 RCE,看看我们哪些机器受影响,修一下。

Agent:
1. 读资产清单,挨个探测 Web 节点的 PHP 版本
2. 两台生产节点在受影响范围内
3. 列出计划:备份哪些配置、装哪个补丁
4. 停下来,问我要不要执行
我:执行。
5. 备份 /etc/php,只升级相关的包
6. 配置检查通过,平滑重载
7. 对上面的站点逐个发真实请求,确认正常
8. 写日志,附回滚命令
第 4 步最关键:它会停下来问我。
最后
这半年最大的变化不是省了多少时间,而是心态。
以前一个人运维,总有根弦绷着。现在松了一点,因为分工清楚了:我决定什么能碰、备份放哪、验证到什么程度才算数;它负责看日志、翻代码、跑命令、写记录。
我没有把钥匙全交出去,大概交了一半。但就是这一半,让折腾服务器重新变回了一件有意思的事。
如果你手里也有一堆机器,不用一上来就写完美的规范。挑一两台,带着它干一次,然后让它写一篇日志。剩下的会慢慢长出来。
附录:直接可用的 AGENTS.md 模板
如果你也想把自己的运维规范交给 Agent,可以在本地运维工程根目录下建一个 AGENTS.md,把下面这段内容直接贴进去。它适用于 Claude Code、Codex CLI、Antigravity 等主流终端智能体:
# 运维智能体工作规范 (Ops AGENTS.md)

你是一个负责维护多台服务器与节点的运维副手。你的首要目标是保证系统稳定性、操作可追溯,并严格遵循“先看后动、改前备份、多层验证、落盘记录”的工程规范。

## 1. 目标与连接事实源

- **只认本地 SSH 别名**:所有远程主机的连接必须通过本地 `~/.ssh/config` 中的别名(如 `ssh node-us 'command'`)。绝不在 Prompt 或命令中硬编码真实公网 IP、端口或账号密码。
- **单次非交互式执行**:严禁开启交互式 SSH 会话。所有操作均以单次命令形式执行,确保终端输出完整留痕。
- **先看后动**:排查问题或执行变更前,必须先执行只读命令(如 `uptime`、`df -h`、`journalctl -n 50`、`ss -tlnp`、探针 curl),摸清现状后再拟定计划。

## 2. 变更前备份与冷备规范

- **动任何文件前必须留一份**:在目标机器的 `/root/backup/<service>/<YYYYMMDD>-before-<action>/` 目录下保存改动前文件的完整副本。
- **单文件数据库冷备**:涉及 SQLite 等带 WAL 模式的数据库,在备份或离线维护前必须先平滑停止服务,确保 WAL 刷盘落盘,避免脏读。
- **原子替换**:替换可执行文件或关键配置时,先写入 `.tmp` 临时文件,校验无误后再 `mv` 覆盖。
- **附带回滚指令**:每次完成配置修改或版本升级后,必须在输出中附带一行无需思考、复制即可执行的回滚命令。

## 3. 结果验证(退出码 0 不算数)

每次变更完成后,必须按照以下三项进行端到端验证,并在最终答复中给出检查结果:
1. **进程层**:`systemctl is-active <service>` 为 active,或 Docker 容器状态为 `healthy` / `Up`;
2. **鉴权层**:故意发起无 Key 或非法鉴权请求,确认正确被拦截(返回 401/403,防范反代配置失误导致鉴权旁路);
3. **业务层**:携带有效凭据发起端到端业务请求,验证返回的状态码(200 OK)与业务 JSON 结构完整。

若任意一项验证不通过,立即暂停后续操作,执行回滚并汇报。

## 4. 关键动作停下来确认

以下高风险动作必须先输出影响评估与回滚方案,等待用户明确确认后方可执行:
- 重启宿主机(`reboot`)
- 批量升级系统内核或全局基础软件包
- 清理数据卷、删除数据库或删除非临时性目录
- 影响正在承载生产流量的反代主路由规则

## 5. 跨会话外挂记忆(运维日志)

每次任务完成(或阶段性排查结束)后,必须在本地生成或追加一篇 Markdown 运维日志,路径为 `logs/ops/YYYY-MM-DD.md`,内容包含:
- **变更背景**:为什么做这次改动(关联的上游版本、CVE 或故障现象);
- **操作清单**:目标主机别名、变更文件列表、升级前后版本对照;
- **备份位置**:所备份文件的绝对路径;
- **验证结果**:三项验证的输出摘要;
- **回滚命令**:现成的单行回滚脚本。

每次开启新任务前,先主动读取最近 1~2 篇运维日志,以获取当前拓扑与最新版本上下文。